쿠버네티스를 사용하기 이전에는
1. 개발과 모니터링은 서로 엮일 수 밖에 없는 구조
2. 개발에서는 한번도 써보지않은 (개발 시스템을 위한) 모니터링 시스템을 만드는 구조
3. 오픈시 개발 프로젝트와 자동으로 같아지는 범위의 App들을 모니터링 하게 되는 구조
개발자는 로우레벨 로그를 일일히 찾고 뒤져야하므로 문제 원인 파악에 시간할애를 많이 할수있다.
쿠버네티스로 IT 인프라 구축 시
쿠버네티스 생태계에있는 로깅,모니터링 툴들을 쓰면 위의 문제들이 해결된다.
로우레벨 로그를 수집, 하이 레벨로 요약/시각화 하여 개발자의 시스템 가시성과 문제 대응 능력을 끌어올린다.
모니터링에는 대표적으로 Grafana , Promethus
로깅에는 loki , elastic, logstash 가있다 .
실습에서는 Grafana, Prometheus , Loki를 설치하여 진행하였다.
Grafana 와 Prometheus는 다음과 같이 역할이 다르다.
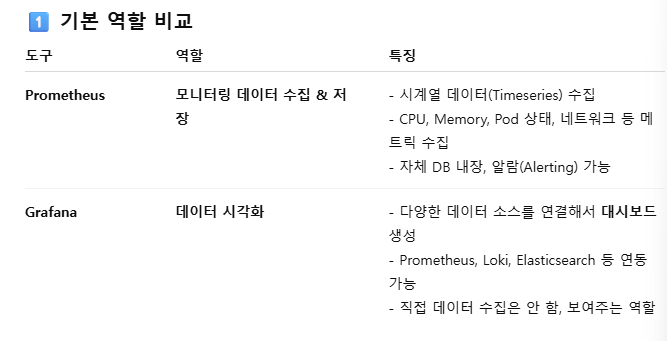
2️⃣ Prometheus → Grafana 흐름
- Prometheus가 Kubernetes에서 메트릭을 수집
- 예: Pod CPU 사용량, Memory 사용량, Node 상태 등
- Grafana가 Prometheus 데이터를 읽어서 시각화
- 예: 대시보드, 그래프, 알람, 색상 강조 등
- 즉, Prometheus는 데이터 공급, Grafana는 데이터 소비/시각화 역할
[Kubernetes 클러스터] → Prometheus → Grafana → 사용자 대시보드
쿠버네티스의 대표기능은 traffic routing , self-healing auto-scaling Rolling update 가 있고
초기 YAML 설정에서 일부 정의해서 시작한다. 이 기능들은 k8s 컨트롤러가 런타임에 자동으로 수행한다.
YAML 예
① Deployment – 앱을 쿠버네티스에 배포
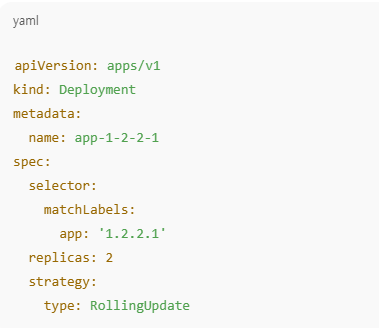
핵심
1. replicas : 2
-> 항상 2개의 파드(Pod)가 떠 있도록 유지(self-healing 기반), 하나가 죽으면 컨트롤러가 자동으로 새 파드를 만듬
2. strategy : RollingUpdate
-> 새 버전 이미지로 바꿀 떄 한 번에 모든 Pod를 내리지 않고, 점진적으로 교체 , 서비스 중단 없는 배포(무중단 배포)
② Pod 템플릿 부분
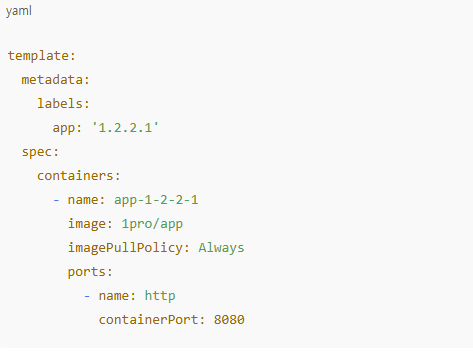
핵심
1. imagePullPolicy: Always
-> 배포할 때마다 항상 최신 이미지를 가져오도록 설정.
2. containerPort : 8080
-> Pod 내부에서 앱이 열고 있는 포트 번호
③ Probe 설정 (Self-Healing + 안정성 핵심)
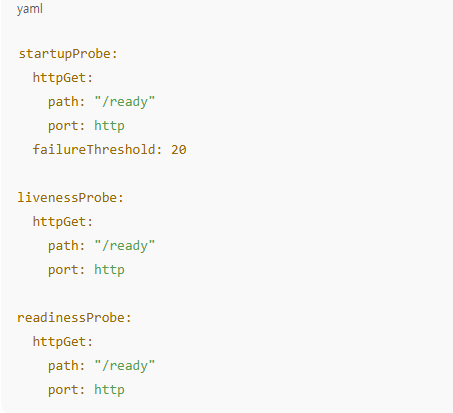
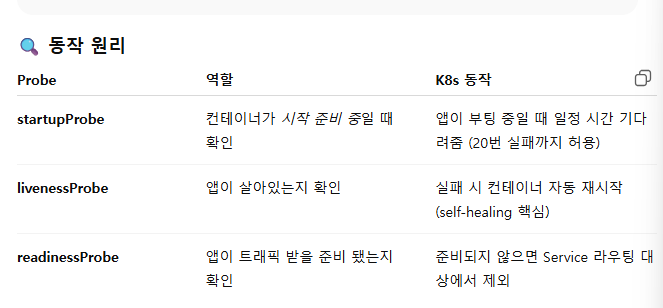
"죽으면 살리고, 준비 안 됐으면 트래픽 제외" -> 쿠버네티스 자동 수행(헬스체크 + 복구)
④ 자원 제한 (리소스 요청 / 제한)
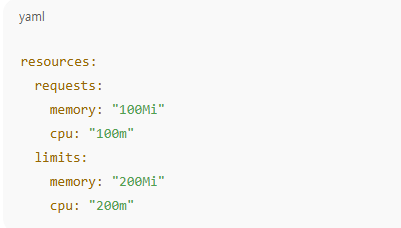
핵심
1. request -> 최소 보장 자원(스케줄링 기준)
2. limits -> 최대 허용 자원(이걸 넘으면 Pod가 throttle 또는 OOMKill 됨)
위 설정은 HPA(오토스케일러)가 참고하는 지표로도 활용
⑤ Service – 트래픽 라우팅 (Traffic Routing)

동작
- selector가 Deployment의 label(app:'1.2.2.1')과 매칭 -> Pod 자동연결
- NodePort는 모든 워커노드 IP의 31221 포트에서 트래픽을 받아 Pod로 전달
http://<Node IP>:31221 → Pod:8080
이게바로 Service를 통한 그래픽 라우팅
⑥ HPA – 오토스케일링 (Auto-scaling)
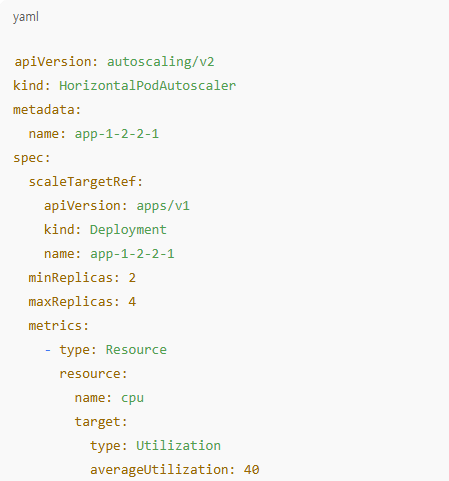
🔍 동작
- scaleTargetRef → 오토스케일링 대상이 되는 Deployment 지정
- averageUtilization: 40 → CPU 사용률이 40% 넘으면 파드 개수 증가
- minReplicas, maxReplicas → 최소 2개 ~ 최대 4개로 제한
HPA가 동작하려면 metrics-server가 반드시 설치 되어있어야함.
🚀 실제 배포 순서
1. yaml 파일 적용
kubectl apply -f app-1-2-2-1.yaml
2. 파드 상태 확인
kubectl get pods -w
3. 서비스 노드포트 확인
kubectl get svc app-1-2-2-1
4. CPU 부하 걸어 테스트(HPA 동작 확인)
kubectl run -it load-generator --image=busybox /bin/sh
> while true; do wget -q -O- http://app-1-2-2-1:8080; done
실습에서 Pod를 강제적으로 kill 하더라도 기본적으로 replica 를 2로 뒀기때문에 다시 Pod가 띄워진다.
App 에 Memory Leak(메모리 누수)을 강제로 나게하면 트래픽을 Pod는 하나가 죽을 것이다.
재시작의 숫자가 바뀌었다면 Pod가 죽었다 되살아난 상황으로 grafana 에서 메모리 상황을 보고
해당 Pod를 찾아 roki에서 로깅을 보고 어느쪽에서 문제가 있었는지 파악하는 것을 권장한다.
CPU 부하가 오고 40%를 넘으면 Pod를 추가생성해 리소스를 분산시킨다.
반대로 40% 이하로 내려가면 Pod 수를 줄여 리소스를 절약한다.
설치하고 실습해보면서 발생한 상황
1. grafana 설치 다하고 구동다했고 running 중이지만 접속이 안되고 있음
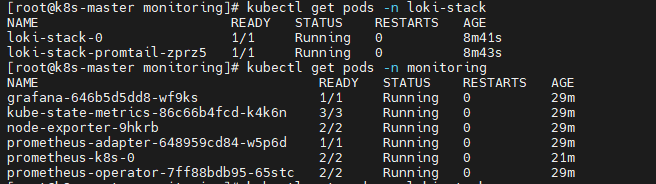
위와같이 구동중이지만
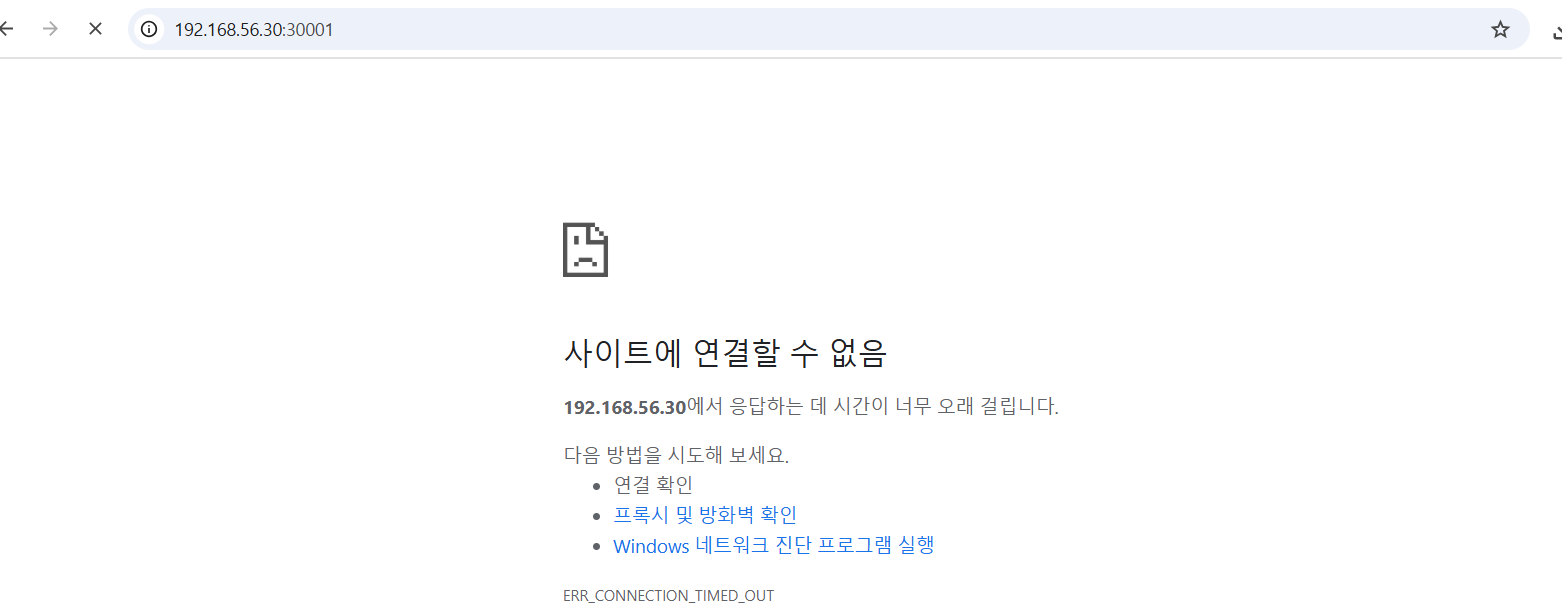
실습작업 하던중에 soft lockup 이 떠서 확인해 보니 이 현상은
커널이 일정시간 (보통 20초 ~ 60초) 동안 CPU에서 context switch를 못한 상태라고 한다.
원인은 대게 CPU 과점유, 메모리 부족
램 부족 이나 I/O 지연이 CPU 스케쥴을 막는 상황에서도 뜸
나의 상황
1. Prometheus가 메트릭 수집중 -> CPU + 램 사용량 급증
2. RAM 6기가 환경에서는 I/O 캐시 부족 -> kswapd(스왑 관리 데몬) CPU 독점
3. containerd, Prometheus 스레드가 50초 이상 CPU 타임을 못받음
4. 커널 watchdog이 감시 타이머 초과 감지
그래서 vargrant file 에서 램을 2기가 추가로 설정 하였고 결국 접속이 가능하게 되었다.
다만 이건 가상화 오버헤드 문제이기 때문에... 실제서버는 훨~씬 성능이 좋기 때문에 걱정할 이유는 없을거같다.
운영환경에서 HPA, 모니터링, Prometheus가 잘 작동하려면 라벨,네임스페이스,이름, 규칙을 엄격히 설계할 필요가 있다.
Object 그려보며 이해 필수 -> 30%만 모든걸 이해하려하지말고 무엇이 있는지만 먼저 파악
1. 네임스페이스(namespace)
- 각 서비스, 팀, 환경(dev, staging, prod)을 논리적으로 분리함.
- 리소스 이름은 네임스페이스 내에서만 유일하면 됨.
- 운영에서는 반드시 서비스별 네임스페이스를 구분:
anotherclass-123 ← 예시
monitoring
production - HPA, Deployment, Service 모두 같은 네임스페이스에 있어야 작동함.
다르면 scaleTargetRef 연결 안 됨.
2. 라벨(label)
라벨은 운영 자동화와 모니터링의 기준 키(key).
Prometheus, Grafana, ArgoCD, Helm, GitOps, NetworkPolicy 등이 전부 라벨 기반으로 동작함.
예시 권장 구조
app.kubernetes.io/name: api-tester
app.kubernetes.io/instance: api-tester-1231
app.kubernetes.io/version: "1.0.0"
app.kubernetes.io/component: backend
app.kubernetes.io/part-of: k8s-anotherclass
app.kubernetes.io/managed-by: dashboard
- 이 표준(app.kubernetes.io/...)은 CNCF가 권장하는 공통 라벨 규격.
- Prometheus와 Grafana는 이 라벨로 서비스별 메트릭을 필터링함.
3. 리소스 이름 규칙
- 이름은 소문자, 숫자, 하이픈만.
- 의미 체계를 유지하면 운영 중 디버깅이 쉬움.
<서비스명>-<버전>-<환경>
예: api-tester-1231-prod
4. Prometheus 연동 관련
Prometheus가 ServiceMonitor를 통해 메트릭을 긁을 때도 라벨 일치가 필요함.
selector:
matchLabels:
app.kubernetes.io/name: api-tester
따라서 Service나 Pod가 올바른 라벨을 가져야 Prometheus가 인식함.
요약
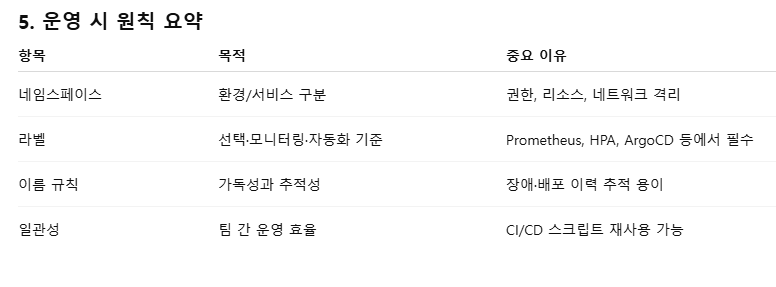
운영 배포 시 네임스페이스 맞추고, 라벨을 표준화된 형식으로 붙이고, 서비스명 일관성 유지 필수
위 세가지가 맞지 않으면 모두 연결이 끊긴다. (Prometheus, HPA, 모니터링, GitOps)
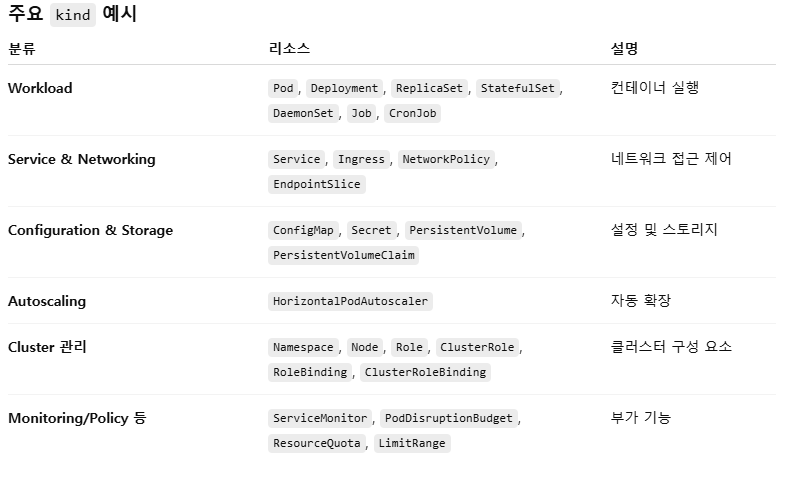
쿠버네티스에서는 kind는 리소스의 종류(type)를 나타내며, 임의로 바꿀수없다.
즉 , k8s API가 인식하는 공식 리소스 타입 목록 중 하나여야 한다.
'개인스터디' 카테고리의 다른 글
| 5장. 쿠버네티스 configMap, Secret (0) | 2025.10.09 |
|---|---|
| 제 4장 쿠버네티스 Pod 의기능 Probe (0) | 2025.10.06 |
| 2장. 쿠버네티스 설치 < VM 환경과 실서버> (0) | 2025.10.04 |
| 쿠버네티스 1장 <리눅스 흐름과 쿠버네티스 컨테이너> (0) | 2025.10.04 |
| 내가 했던 인터페이스에 대한 오해와 진실 (0) | 2024.12.06 |
주니어 모코코 개발자
포스팅이 좋았다면 "좋아요❤️" 또는 "구독👍🏻" 해주세요!